TAG STORY · 故事期刊
產業筆記:資料中心
從 CPU、GPU、TPU 到 HBM、NVLink,一次看懂 AI 資料中心的運作原理。
TAG Story ·
你現在打開一個 AI 聊天工具,輸入問題,幾秒鐘後得到答案。看起來不過是一段文字來回,背後卻是一連串物理事件:資料被傳送到伺服器,處理器將文字轉成數字,晶片執行大量數學計算,記憶體不停搬運資料,網路協調不同機器,供電與散熱設備則讓整套系統能持續運轉。
人們習慣說「AI 需要算力」。但算力從來不是只有一顆更快的晶片,而是一整套能讓計算持續、有效、可靠發生的基礎設施。
如果把資料中心當作一座工廠,處理器是機器,記憶體是機器旁的料架,網路是運輸道路,電力是能源,散熱是廠房的環境控制。任何一環跟不上,昂貴的機器也無法發揮全部產能。
這篇文章將回答八個問題:資料中心在做什麼?CPU、GPU、TPU 有何差別?什麼叫平行運算?GPU 怎麼產生 AI 答案?HBM 和 NVLink 為什麼重要?電力如何限制擴張?資料中心如何賺錢?以及,業內人士究竟在問什麼?
01|資料中心不是「存資料的房間」
Data Center(資料中心) 是將伺服器、資料儲存、網路、電力、散熱、監控與安全系統整合在一起的實體設施。它讓網站、企業系統、雲端平台與 AI 服務能夠全天候運作。
先認識五個部分:
系統 | 中文意思 | 它負責什麼? |
|---|---|---|
Compute | 運算 | CPU、GPU、TPU 執行程式與數學計算 |
Storage | 儲存 | SSD、HDD 保留資料、模型檔案與備份 |
Networking | 網路 | 交換器、路由器、光纖讓設備交換資料 |
Power | 供電 | 電網、變壓與 UPS 等設備提供可靠電力 |
Cooling | 散熱 | 風冷、液冷、熱交換設備將熱量排出 |
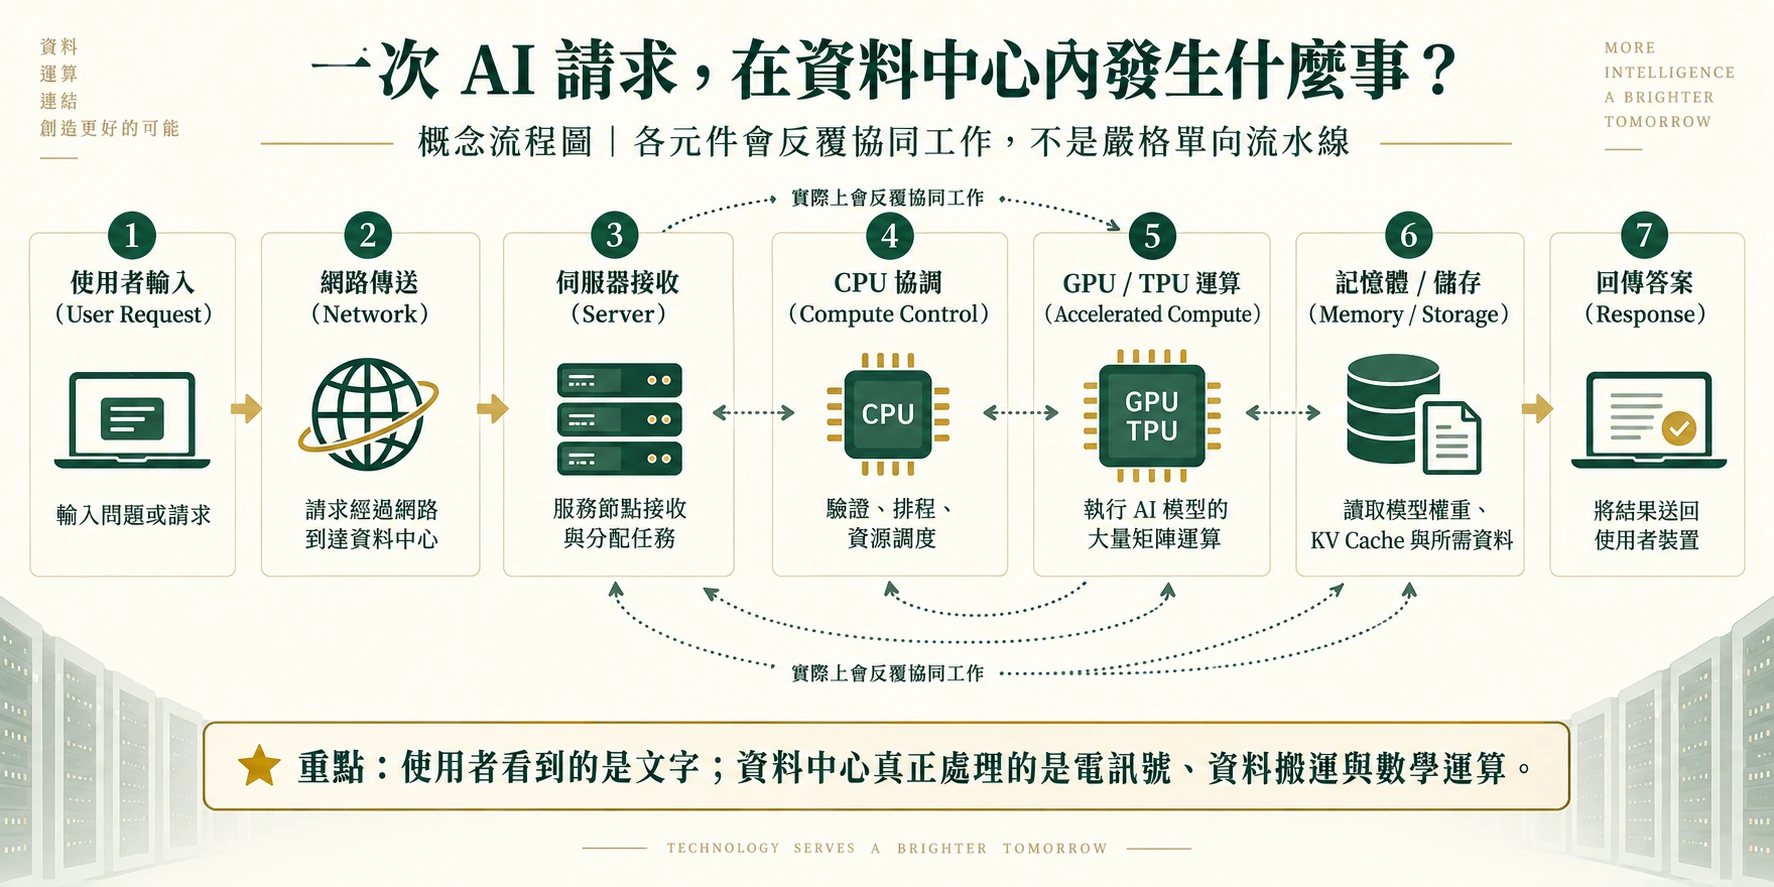
拿你使用 AI 的過程為例:輸入先透過網際網路到達服務系統;CPU 或其他通用處理器負責部分控制、排程與資料處理;GPU 或 TPU 執行模型運算;記憶體提供模型參數與中間資料;結果再經由網路送回你的螢幕。
這裡要分清兩個常混用的概念:資料中心是物理設施,Cloud Computing(雲端運算)是利用這些設施,按需求提供運算與儲存資源的服務模式。 你租用雲端伺服器,不代表電腦消失了,而是有人代你管理底下的硬體與機房。
02|CPU、GPU、TPU:三種不同的運算角色
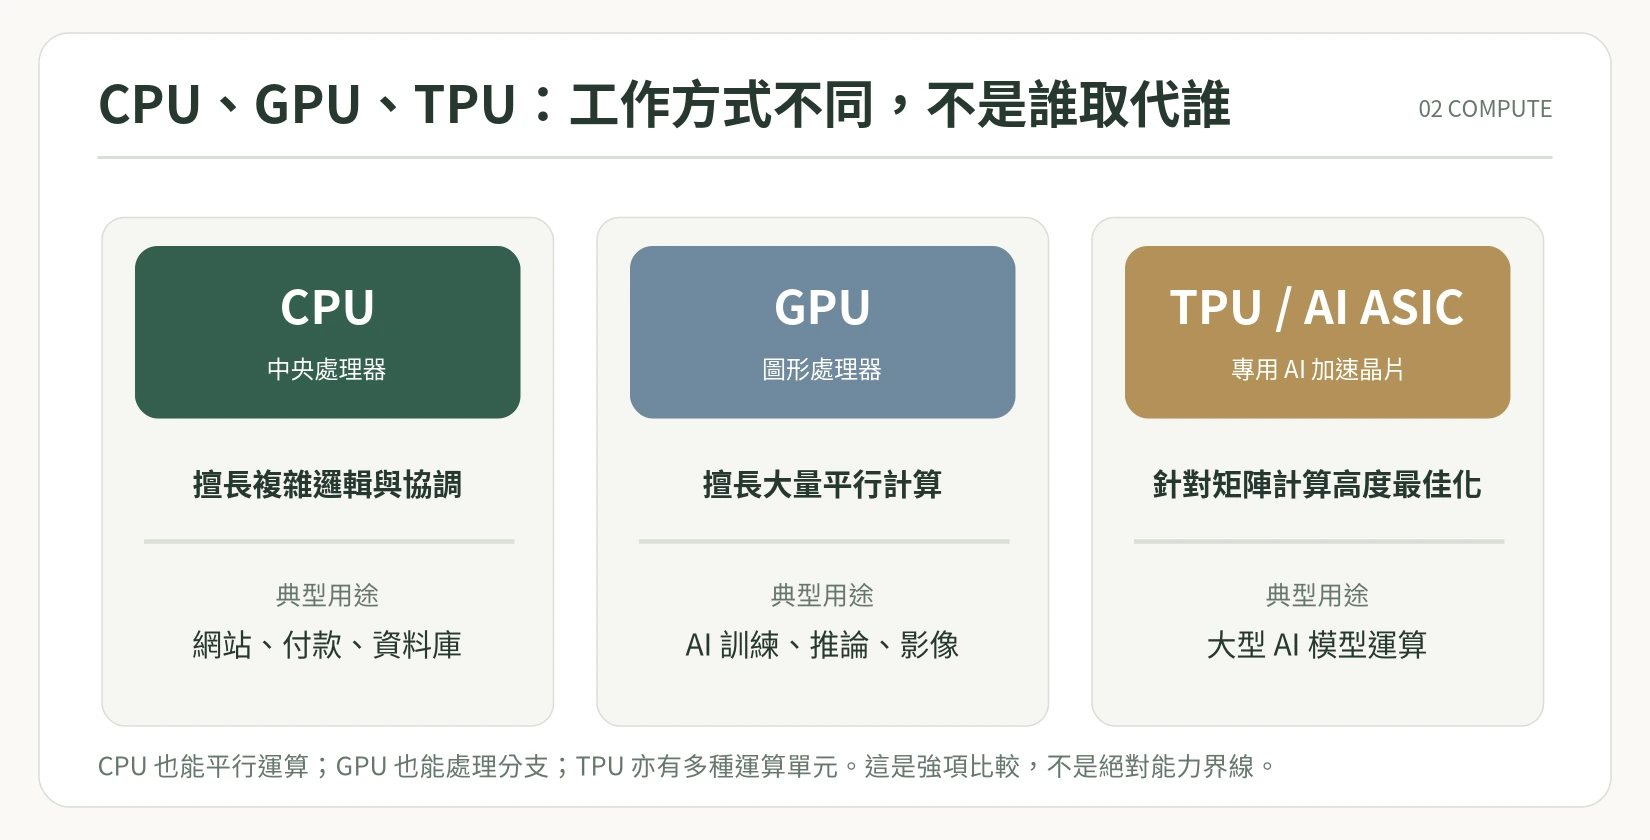
CPU:擅長處理複雜又多變的工作
CPU(Central Processing Unit,中央處理器) 是通用型處理器。想像一位能處理多種狀況的專業經理人:驗證帳號、查詢資料庫、判斷付款結果、調度其他工作、處理例外事件,都在他的能力範圍內。
CPU 不只做一件事,也可以有很多核心(Cores)同時工作。但它的設計長處通常在於通用性、複雜控制流程、較低的單一任務延遲,以及多樣化的程式需求。
實際場景: 網站後端、金流、銀行交易系統、企業 ERP、資料庫、伺服器作業系統,以及 AI 服務的資料預處理和工作排程。
GPU:擅長把大量相似的數學工作同時完成
GPU(Graphics Processing Unit,圖形處理器) 最初因電腦圖形需求而發展,現在已成為 AI 運算的重要加速器。
假設你有 10,000 張照片,都要進行相似的亮度調整。與其讓一個工作者一張接著一張處理,不如把照片分給大量工作者同時運算。GPU 的硬體特別適合這一類可以切成很多份、彼此相對獨立的工作。
現代 AI GPU 還有 Tensor Cores(張量運算核心) 等設計,可以有效加速深度學習經常使用的矩陣乘法。
實際場景: AI 模型訓練、模型推論、影像和影片處理、3D 繪圖、科學模擬、分子研究。
TPU:為 AI 計算設計的專用加速器
TPU(Tensor Processing Unit,張量處理單元) 是 Google 設計的 AI 加速晶片,屬於 AI ASIC(Artificial Intelligence Application-Specific Integrated Circuit,人工智慧專用積體電路)。
ASIC 的意思是「針對特定應用設計的晶片」。如果 GPU 是設備很多、用途廣泛的工廠,AI ASIC 更像針對某一類生產流程特別設計的產線。TPU 針對深度學習常見的矩陣計算,採用 MXU(Matrix Multiply Unit,矩陣乘法單元) 等架構,力求提高效能與能源效率。
實際場景: Google Cloud 上的大模型訓練與推論,使用 JAX、PyTorch 等受支援工具的機器學習工作。除了 Google TPU,AWS Trainium、Inferentia 也是其他企業的專用 AI 加速器例子。
最重要的區別: CPU 重視通用性,GPU 擅長大規模平行運算,TPU 等 AI ASIC 則針對特定 AI 工作負載進一步最佳化。它們通常彼此協作,而非只能三選一;哪個更划算,還取決於軟體工具、模型類型、實際效能、採購與能源成本。
03|平行運算究竟是什麼?「足夠平行」又是什麼?
Parallel Computing(平行運算),就是把能分開處理的工作,交給多個運算資源同時進行。
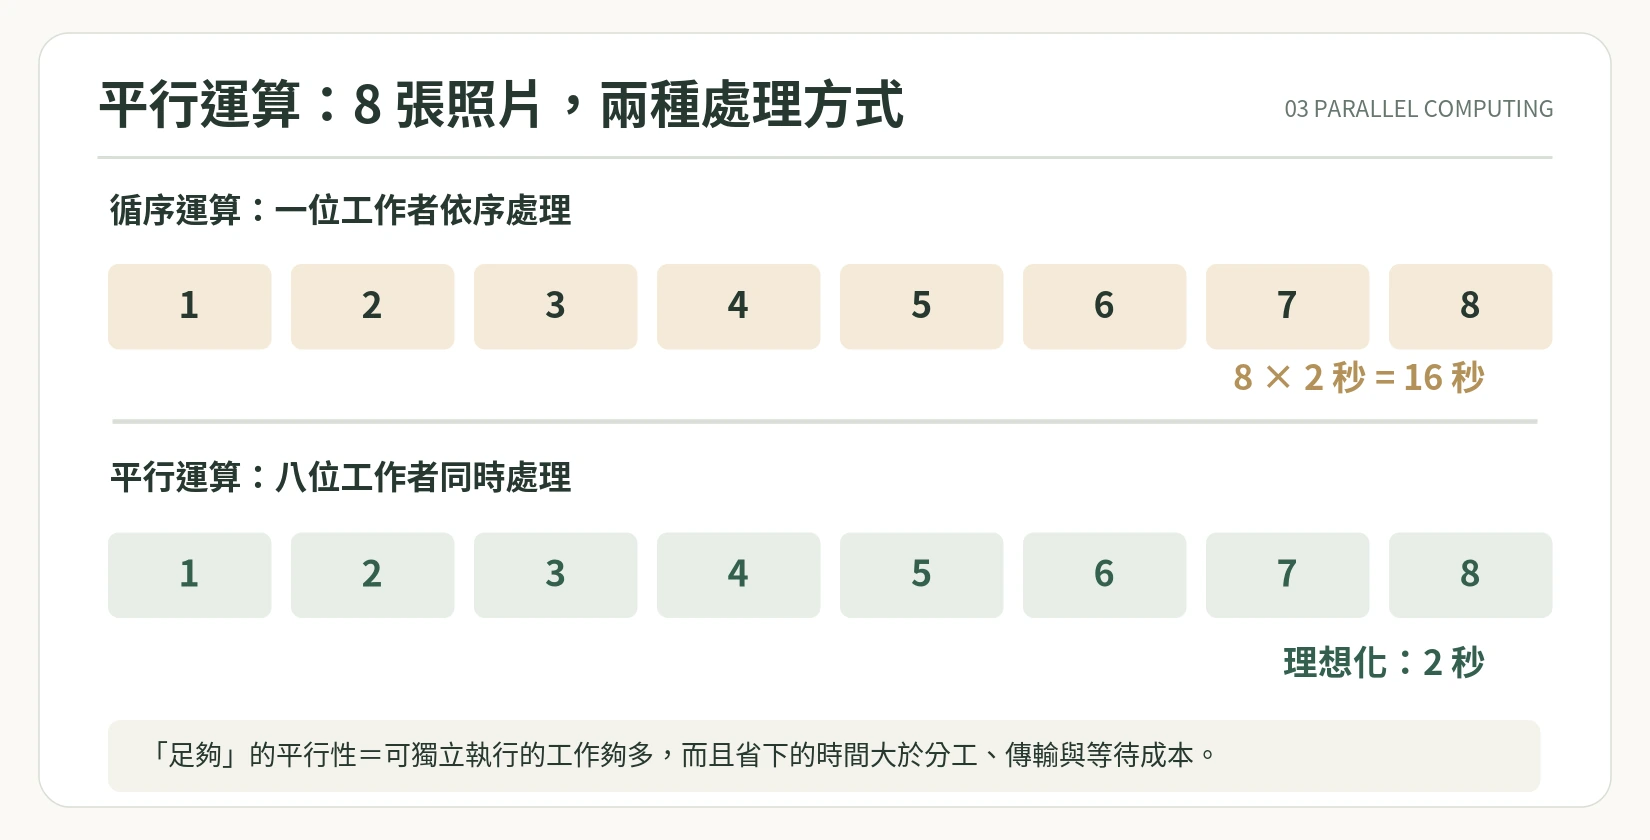
這裡真正重要的是 Dependency(相依關係)。八張照片可以獨立調色,不必等彼此完成;但烤蛋糕時,麵糊要先調好才能進烤箱,烤好後才能裝飾。就算請來一百位廚師,某些步驟仍然不能同時發生。
所以「有很多核心」不等於「一定很快」。工作必須真的能被拆開,而且分工能帶來淨收益。
什麼叫「足夠」的平行運算?
判斷標準有兩個:
第一,獨立工作量夠多。 如果只要計算兩個極小的數字,為了動用整張 GPU 而安排數千個運算資源,可能反而浪費。若是幾百萬個像素或大型矩陣,GPU 就更有機會發揮效益。
第二,節省時間必須超過額外成本。 把工作交給 GPU,可能產生資料傳輸、啟動運算程式(Kernel)、協調與同步等待等成本。若做事只要 1 毫秒,交辦與搬資料卻要花 5 毫秒,平行化就未必值得。
因此,「足夠」不是固定的 100 項、1,000 項或 10,000 項,而是一個需要用實際工作負載測試的門檻。
04|GPU 究竟如何產生一句 AI 回答?
很多人以為 AI 回答問題,是從巨大資料庫裡找出一段現成文字。大型語言模型的主要運作方式並不是如此。
以常見的 Transformer(轉換器模型) 為例,過程可以簡化成五步。
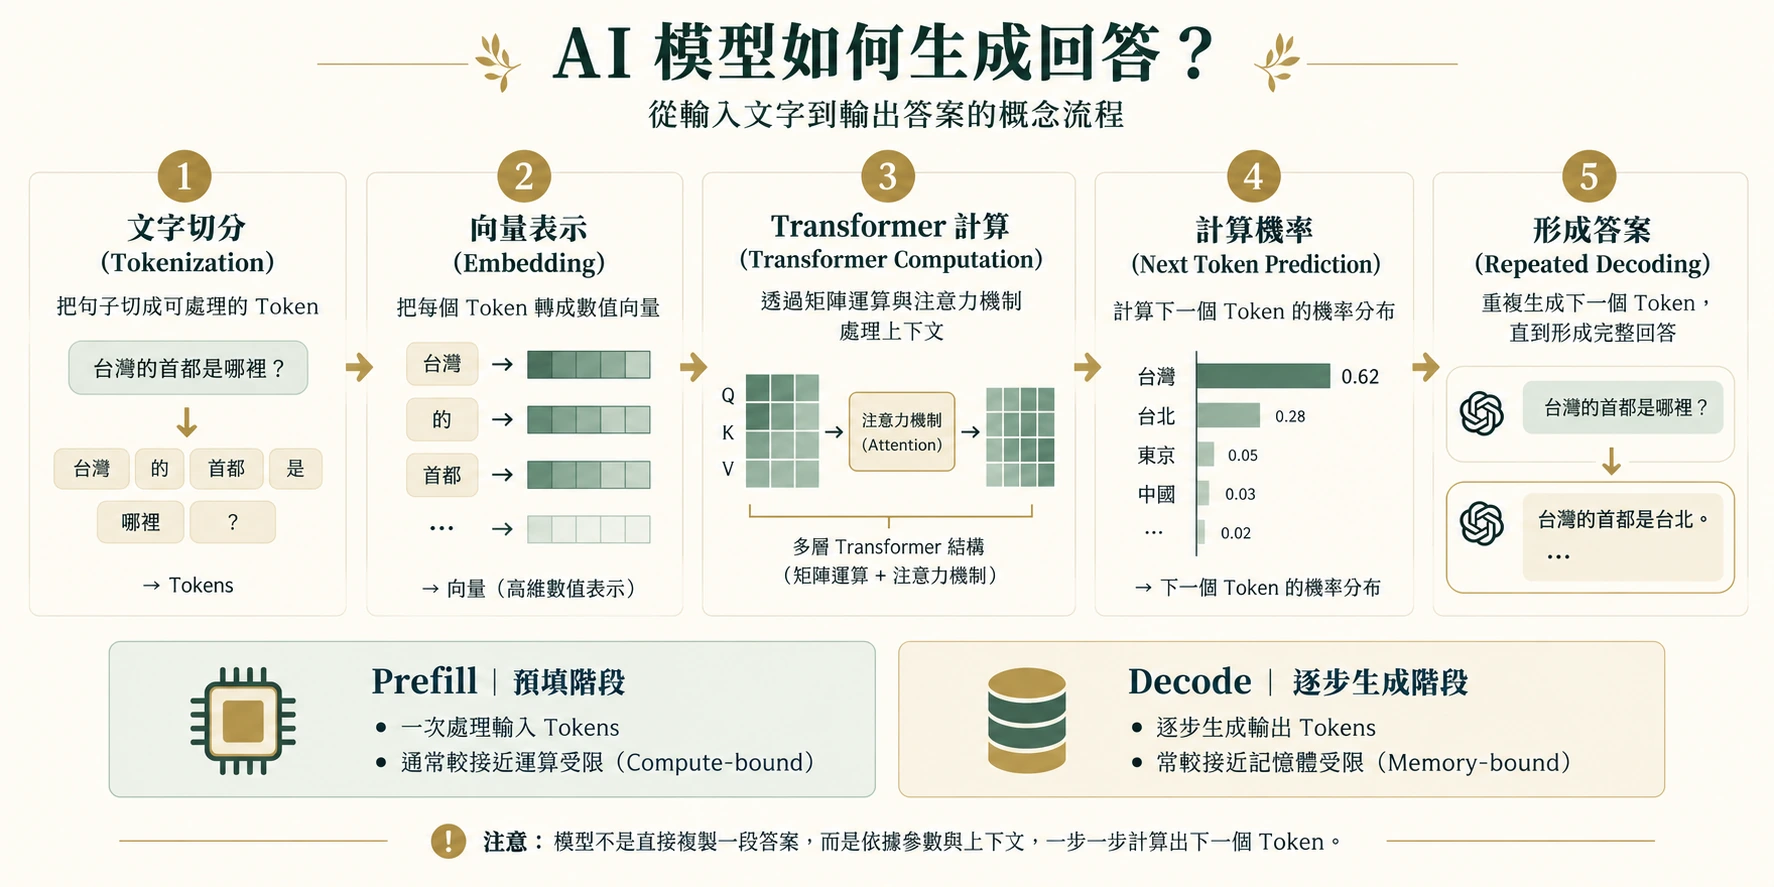
一、Tokenization(文字切分):把輸入文字切成 Tokens(詞元),每個 Token 對應數字 ID。Token 不一定等於一個中文字或英文單字。
二、Embedding(向量表示):把 Token 轉換為一組數字向量,讓模型可以用數學方式處理語言。
三、Matrix Multiplication(矩陣乘法)與 Attention(注意力機制):大量參數矩陣處理數值表示;注意力機制讓模型依據上下文整合不同位置的資訊。GPU 或 TPU 的特殊優勢就在這裡。
四、Next-token Prediction(下一詞元預測):模型計算下一個 Token 的分數與機率分布,再依照輸出策略選出下一個 Token。
五、重複生成:對一般自回歸語言模型而言,後一個 Token 的產生依賴前面已生成的內容,因此答案通常逐步輸出,而不是全部一次算好。
Prefill 和 Decode:一個模型,兩種瓶頸
Prefill(預填階段) 處理一批輸入 Tokens,常有大量可平行的矩陣計算,容易接近 Compute-bound(運算能力受限)。
Decode(逐步生成階段) 則依序產生輸出 Tokens。在 Batch Size(批次大小)較低時,系統可能反覆搬運模型權重與快取,因此較容易 Memory-bandwidth-bound(記憶體頻寬受限)。
這不是絕對定律。批次大小、模型架構、上下文長度與軟體實作,都會改變瓶頸。也因此,同一張 GPU 處理不同 AI 工作時,效能差距可能很大。
05|HBM:為什麼晶片很會算,還是要等?
HBM(High Bandwidth Memory,高頻寬記憶體) 是高階 AI 加速器常使用的高速記憶體技術。它讓晶片能快速取得模型參數、KV Cache(鍵值快取)與各種中間資料。
這裡一定要分清兩件事:容量與頻寬。
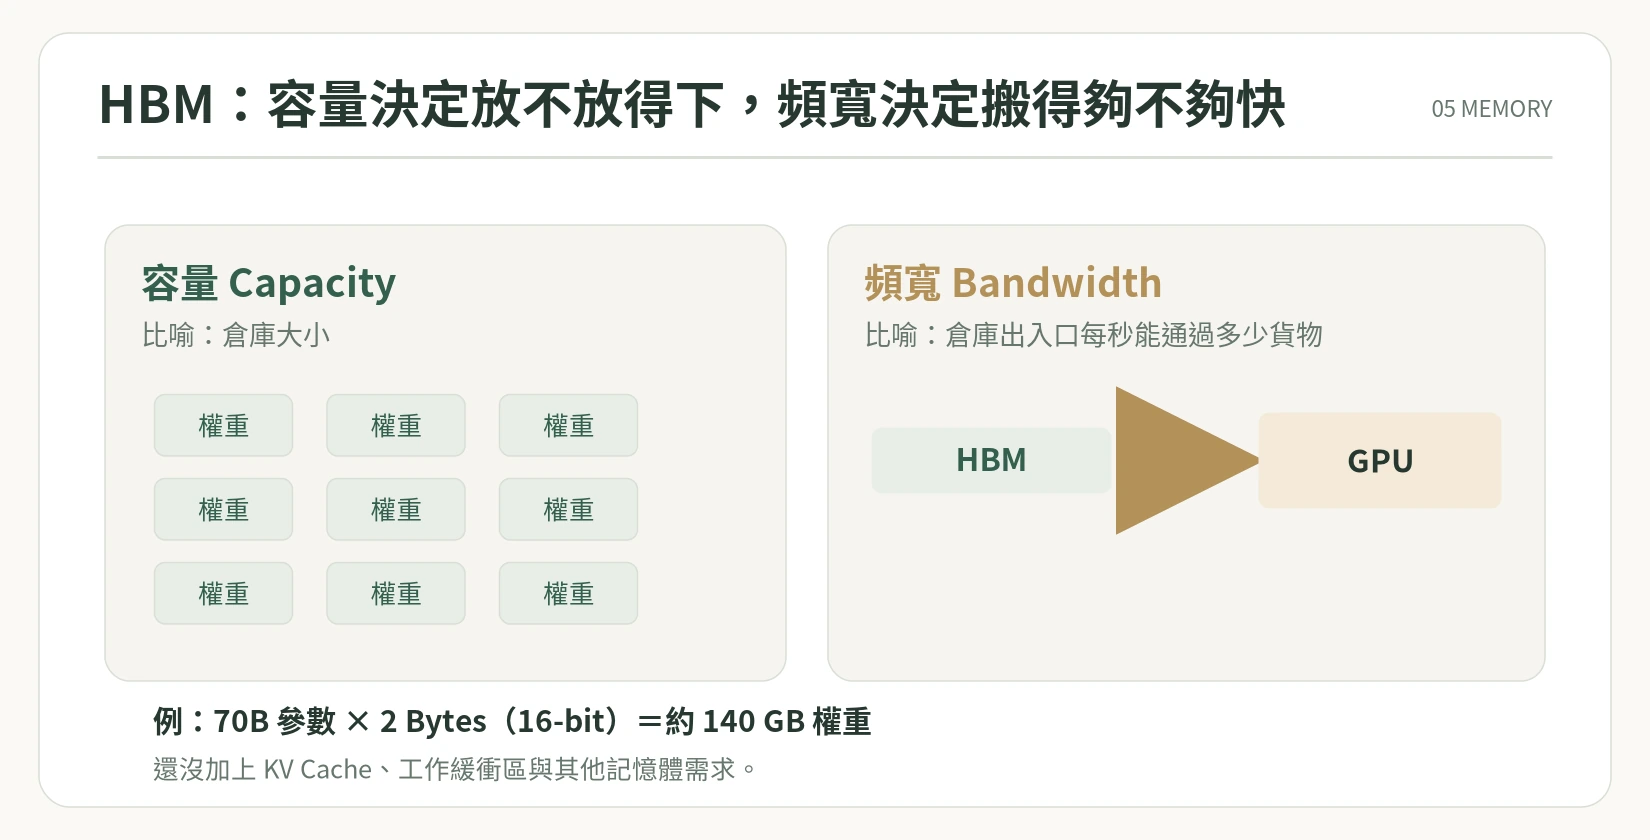
• Capacity(容量):放不放得下模型與必要資料?單位常見 GB。
• Bandwidth(頻寬):每秒能讀寫多少資料?單位常見 GB/s 或 TB/s。
例如一個 70B(700 億參數) 的 Dense Model(稠密模型),若每個參數以 16-bit 儲存,單看權重便需要:
700 億 × 2 Bytes = 約 140 GB。
若改用理想化 8-bit 儲存,權重約為 70 GB;4-bit 則約 35 GB。但這些只是權重數字,還不包含量化額外資訊、KV Cache、工作空間與其他開銷。它們也不代表模型品質完全不受精度影響。
KV Cache(鍵值快取) 是推論時儲存先前 Tokens 的注意力資訊,避免每產生新 Token 都重算全部歷史內容。它能減少重複計算,卻需要額外記憶體;使用者更多、Context(上下文)更長,記憶體壓力通常也會增加。
因此,單看 GPU 宣傳的 FLOPS(每秒浮點運算次數) 不夠。如果記憶體搬運速度跟不上,運算單元就可能閒著等資料。這就是 Computer Architecture(電腦架構)常談的 Roofline Model(屋頂線模型):系統效能會同時受到峰值運算能力與資料搬運能力限制。
06|NVLink:為什麼 GPU 之間也需要高速道路?
模型越大,或任務越重,就越可能需要多張 GPU 一起完成。但多張 GPU 不是插在一起就能自動變成一張巨大的 GPU。
NVLink(NVIDIA 高速互連技術) 讓多張 GPU 可以高速交換資料;NVSwitch(NVIDIA 高速交換晶片/系統) 則幫助多 GPU 建立更大的互連網域。它們主要解決 GPU 協作時的資料傳輸問題。
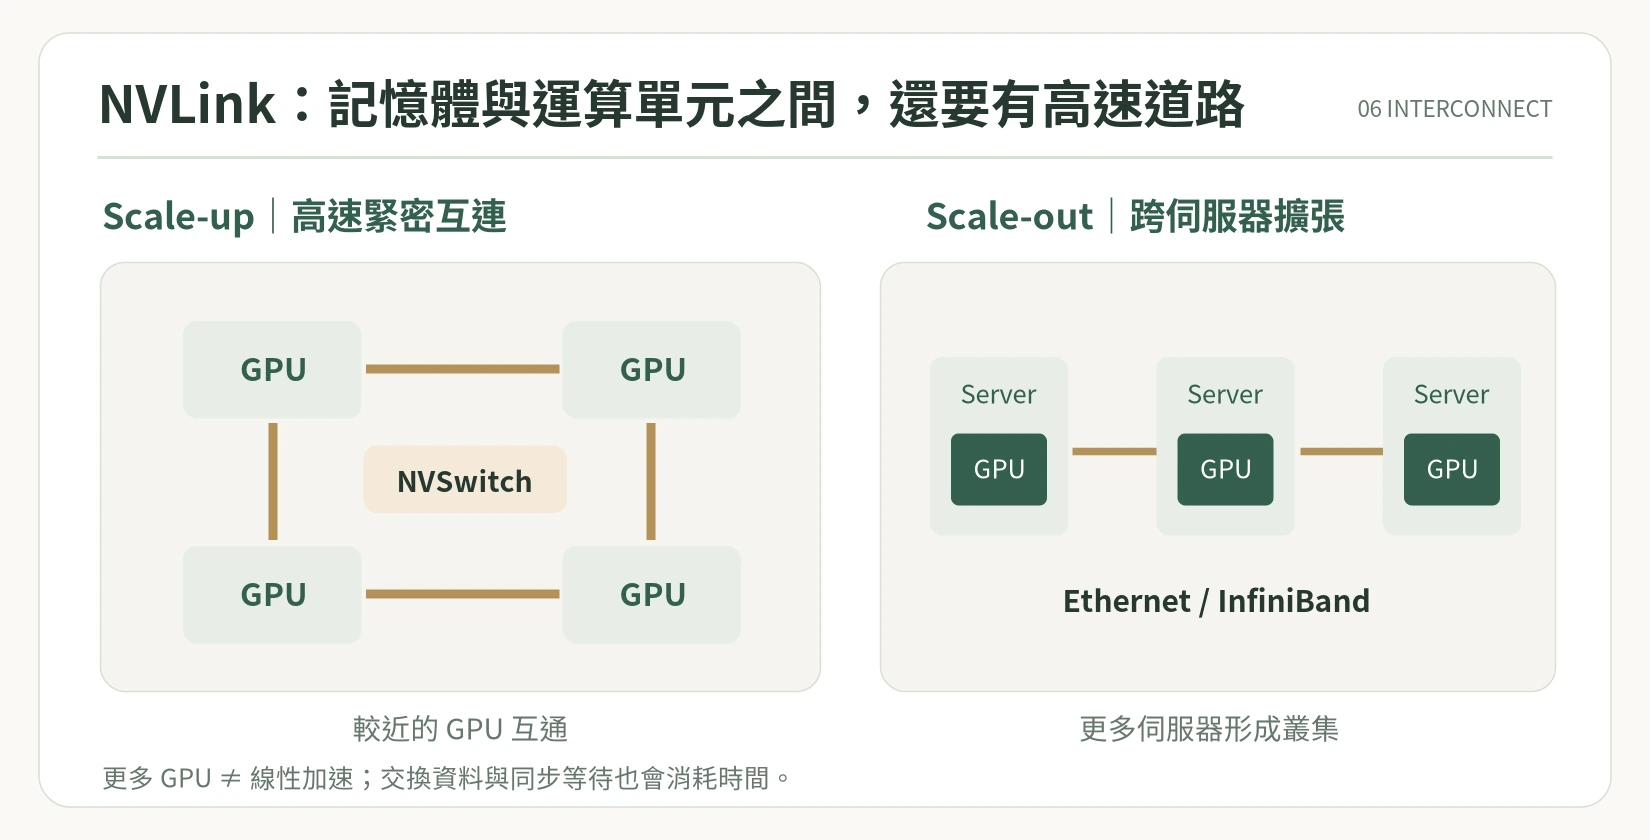
假設一個 AI 模型被拆成四份,由四張 GPU 共同運算。GPU A 算出的中間結果,可能需要交給 GPU B、C、D。若運算只花 2 毫秒,交換資料卻花 5 毫秒,GPU 再快也會被通訊拖累。
這會涉及 Tensor Parallelism(張量平行)、AllReduce(集體規約同步)與 AllGather(集體資料彙整) 等技術。
業界常把擴張分為:
• Scale-up(緊密互連擴充):讓一組加速器以高速、低延遲協作,NVLink/NVSwitch 是常見方案。
• Scale-out(跨節點擴充):將更多伺服器或機櫃連成運算叢集,常使用 Ethernet(乙太網路)或 InfiniBand(高速互連網路)。
NVIDIA 2024 年發表的 Blackwell 第五代 NVLink,每顆 GPU 官方標示雙向合計頻寬為 1.8 TB/s;這是特定產品世代的規格,不等於所有 NVLink 系統,更不等於應用程式一定能達到的有效吞吐量。
一個容易犯的錯誤是:把八張各有 80 GB HBM 的 GPU 想成一張擁有 640 GB、存取速度完全一致的晶片。實際上資料如何切分、放在哪張 GPU、跨裝置存取的延遲,以及軟體是否支援,都很重要。
07|電力與散熱:晶片越強,資料中心越像重工業
加速器需要電力,而消耗的電能最終大多變成熱。更高的運算密度意味著更大的配電與排熱挑戰。
資料中心會談三個問題:Power Availability(可用電力容量)、Rack Density(每機櫃功率密度)、Cooling Capacity(散熱能力)。晶片買得到,不代表電網能按時供電;機櫃放得下,也不代表冷卻系統能帶走熱量。
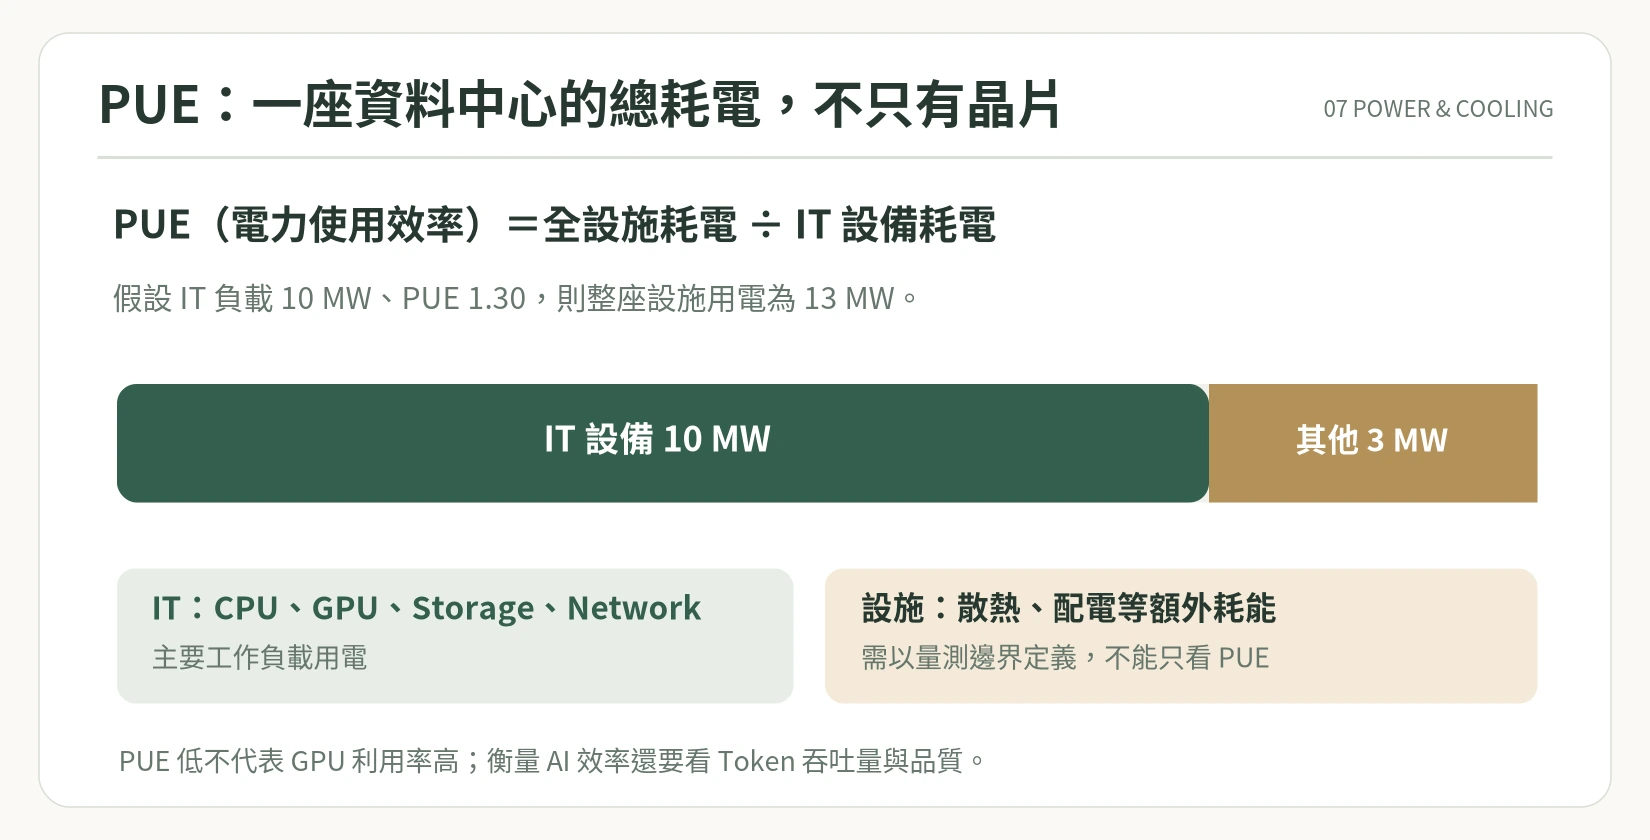
PUE(Power Usage Effectiveness,電力使用效率) 的公式是:
PUE = 全設施總耗電 ÷ IT 設備耗電。
假設 IT 設備消耗 10 MW(百萬瓦)、PUE 為 1.30,整座設施的總用電就是 13 MW,其中約 3 MW 是非 IT 的設施用電。PUE 越接近 1,通常代表額外設施用電比例越低;但PUE 並不能告訴你 GPU 是否真的有效利用,也不等於每個 AI Token 的成本低。
一組有年份的數據可用來理解尺度:Google 公布其 2025 年全球大型資料中心平均 PUE 為 1.09;Uptime Institute 的 2026 年全球資料中心調查則指出,受訪設施的平均 PUE 約 1.52。兩者在設施組成、統計口徑與樣本上不同,不能直接視為同條件的效率競賽。
能源需求也在成長。IEA(國際能源總署)於 2025 年估計,全球資料中心 2024 年用電約 415 TWh(太瓦時);其基準情境預測 2030 年約 945 TWh。後者是預測,不是已經發生的事。
供電除了價格,還有何時正式啟用(Energization)、備援程度、電網穩定性、合約容量及故障處理。真正能出售算力的是持續運作的系統,而不是設備採購清單。
08|為什麼 AI Scaling(擴張)不能只靠增加 GPU?
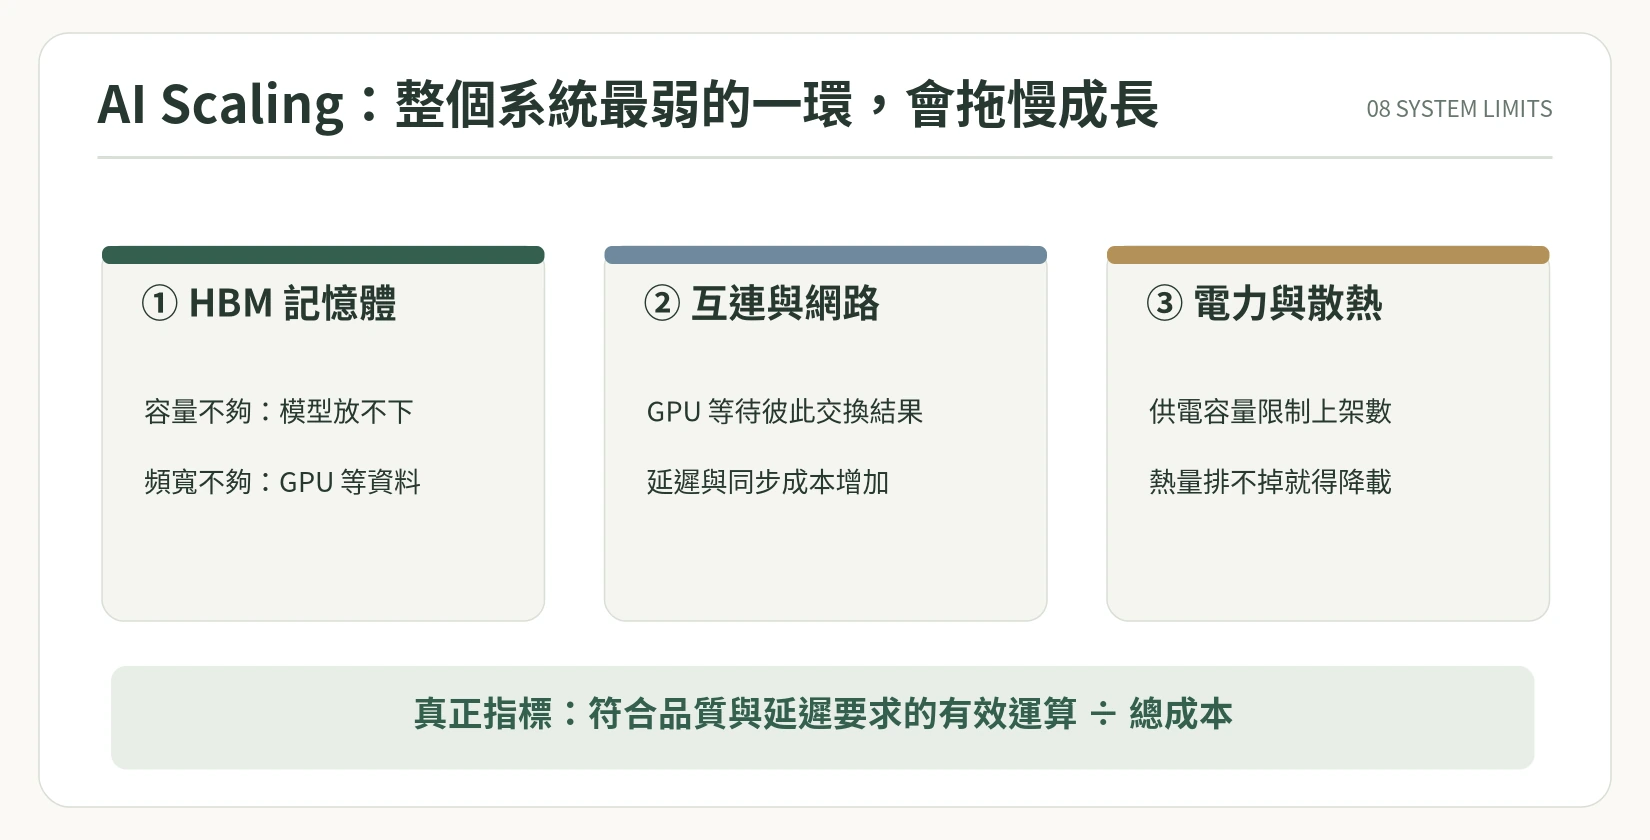
想像一座工廠新買了八台機器,卻仍只有一條貨運道路、原本的供電容量和同樣大小的倉庫。理論產能增加八倍,實際產出不會自動跟著增加八倍。
AI 系統也一樣。如果模型太大,HBM 容量可能不夠;資料頻寬不足,GPU 會等待;需要跨 GPU 協作時,網路和同步成為負擔;電力和液冷未到位,機器就無法滿載。除此之外,軟體排程、記憶體管理及使用者需求,也會限制有效產出。
假設原本單張 GPU 完成一個工作需要 80 秒,改用 8 張 GPU 後花了 14 秒:
加速比 = 80 ÷ 14 ≈ 5.71 倍;平行擴張效率 = 5.71 ÷ 8 ≈ 71.4%。
這個數字不是某款 GPU 的實測,而是說明 Scaling Efficiency(擴張效率) 的算例。並且,要先確認是在比較相同總工作量(Strong Scaling,強擴張),還是隨機器數增加同時擴大工作量(Weak Scaling,弱擴張),否則數字可能沒有比較意義。
在模型推論裡,也必須區分:
• Latency(延遲):單一使用者等待多久?
• Throughput(吞吐量):整套系統每秒能完成多少工作或生成多少 Tokens?
• TTFT(Time To First Token,首詞元等待時間):使用者等多久才看見第一個 Token?
• TPOT(Time Per Output Token,每輸出詞元時間):後續生成 Token 的平均時間間隔。
• Goodput(有效吞吐量):符合品質與 SLA(服務水準協議)條件下,真正可交付的產出。
例如,增加 Batch Size(批次大小)可能提升總 Token 吞吐量,卻也可能拉長某些使用者的等待時間。衡量「快」以前,必須先問「是對誰而言、在哪個條件下快」。
09|資料中心是一門什麼樣的生意?
從商業模式看,至少可以分成三類。
模式 | 客戶購買什麼? | 代表性業者類型 |
|---|---|---|
Colocation(主機代管) | 機房空間、供電、散熱、實體連線 | 專業資料中心營運商 |
Cloud/IaaS(雲端基礎設施) | 按需求租用運算、儲存與網路資源 | 大型公有雲供應商 |
GPU Cloud(GPU 算力雲) | AI 訓練/推論需要的 GPU 資源 | 專業 GPU 雲業者 |
三者可以互相合作,不是絕對互斥。有些公司持有資料中心,有些租用廠房再提供算力,有些在自己的硬體上銷售完整的 AI 模型服務。
商業上不能只看 GPU 數量,至少還要看:實際可用電力、可收費使用率、客戶合約、硬體折舊、融資、網路成本、電價、維護與故障風險,以及每單位有效算力的收入。
一個很好的問題是:兩家公司各有一千張 GPU,為什麼獲利可能完全不同? 因為設備相同,需求與商業化效率不見得相同。長約客戶與 Spot(即時浮動價格)需求,會創造不同的收入穩定性;高使用率也未必代表高毛利率,還要看售價、能源與資本成本。
對投資人或企業決策者來說,真正值得比較的是 在同樣可靠度、品質與延遲要求下,一單位有效運算的總成本與獲利能力。
10|和業內人士談資料中心,該問哪些問題?
不要先問「你們有幾張 GPU?」那只問到設備規模。更有價值的是釐清系統的限制與證據。
第一問:你們說的 100 MW Capacity,到底是什麼容量? 是申請中的電力、已簽約容量、已通電容量,還是真正供 IT 設備使用的功率?何時能投入服務?
第二問:這個 AI 工作負載的主要 Bottleneck(瓶頸)在哪裡? 是 GPU Compute(運算)、HBM Capacity(記憶體容量)、HBM Bandwidth(記憶體頻寬)、GPU Interconnect(互連)、還是散熱?能提供什麼監測數據?
第三問:增加 GPU 之後,Scaling Efficiency 如何變化? 八張變成六十四張後,單一任務快多少?等待通訊的時間有沒有增加?
第四問:你優化的是 Latency,還是 Throughput? 如果是 LLM 推論,Benchmark(效能測試)有沒有標出模型、Batch Size、輸入與輸出長度、TTFT、TPOT 和併發量?
第五問:什麼叫「利用率高」? 是 GPU 活躍率、實際有效運算、容量售出率,還是可以開立帳單的使用率?這幾個數字不能混為一談。
第六問:電力、散熱與網路有沒有相互匹配? 高密度機櫃需要多少 kW?故障時有什麼 Redundancy(備援)?單一共同故障點是否可能讓整批機器停機?
第七問:在真實客戶需求下,完整 TCO(Total Cost of Ownership,總持有成本)是多少? 是否考慮折舊、融資、電費、網路、維護、資安和更新週期?
成熟的技術交流,不是比較誰知道更多縮寫,而是能交代清楚 條件、測量方式、真正瓶頸、改進的代價與商業結果。
結語|未來的算力競爭,是整個系統的競爭
資料中心看似是科技產業,實際上同時涉及半導體、能源、建築工程、軟體、網路、資本與營運。
CPU、GPU、TPU 決定運算如何發生;平行運算決定工作如何分工;HBM 決定資料放不放得下、搬得夠不夠快;NVLink 與其他網路決定多張晶片如何協作;電力與散熱決定整座工廠能不能真正運作。
因此,討論 AI Scaling,不該只問「下一代 GPU 會快多少」,而應該問:在相同品質、延遲與可靠性要求下,整個系統能否以更低的總成本,持續產生更多有效算力?
理解這個問題,就能從晶片規格表,開始看懂資料中心的工程本質,也能更有判斷力地閱讀未來二十年的 AI 基礎設施產業。
專有名詞速查
英文 | 中文 | 一句話理解 |
|---|---|---|
Data Center | 資料中心 | 提供運算、儲存、網路與可靠運作的實體設施 |
CPU | 中央處理器 | 通用性強,適合控制和多樣邏輯工作 |
GPU | 圖形處理器 | 適合大量可平行的數學運算 |
TPU | 張量處理單元 | Google 為 AI 工作負載設計的專用加速器 |
AI ASIC | 人工智慧專用積體電路 | 針對 AI 計算需求高度客製化的晶片 |
Parallel Computing | 平行運算 | 同時執行可拆解的部分工作 |
Transformer | 轉換器模型 | 常見的深度學習模型架構 |
Training / Inference | 訓練/推論 | 學習模型參數/使用模型產生結果 |
HBM | 高頻寬記憶體 | 高速提供模型權重與中間資料 |
KV Cache | 鍵值快取 | 保存先前 Token 的注意力資訊 |
NVLink | NVIDIA 高速互連 | 協助 GPU 之間高速交換資料 |
Scale-up / Scale-out | 緊密互連擴充/跨節點擴充 | 把近距離加速器或更多伺服器連起來 |
PUE | 電力使用效率 | 全設施用電與 IT 設備用電的比值 |
FLOPS | 每秒浮點運算次數 | 衡量運算量速率的單位 |
Latency / Throughput | 延遲/吞吐量 | 單次等待多久/單位時間處理多少 |
TCO | 總持有成本 | 將設備、能源、維護、折舊等一起計算 |